
Sua próxima tarefa de IA pode precisar das palavras em um relatório, dos valores em uma tabela de orçamento ou das instruções em um documento escaneado. Enviar o arquivo original também pode pedir ao modelo para processar a aparência de cada página.
Essa distinção importa quando você paga por token.
O SourceShelf converte PDFs, documentos modernos do Office e texto contido em imagens para Markdown localmente no seu Mac. Você pode revisar o resultado, organizá-lo em um Pacote focado e enviar o conteúdo que sua tarefa precisa para o GPT-6 Astra.
Executamos sete arquivos sintéticos através do código de conversão do SourceShelf para explorar a diferença. Nosso modelo de custo local estimou 84% menos tokens de entrada para um PDF de texto de 40 páginas e 97% menos para um pacote digitalizado com pouco texto de 20 páginas ao comparar o Markdown com um cenário de imagem por página de alto detalhe.
Essas são estimativas ilustrativas, não faturas Astra medidas ou uma promessa para cada documento. A maior oportunidade é remover a sobrecarga de imagem de página do trabalho focado em texto. Markdown não é inerentemente menor que texto simples, e selecionar um trecho é um tipo diferente de economia em comparação com converter um documento inteiro.
Por que o formato original importa
A API Responses da OpenAI lida de forma diferente com os tipos de arquivo. Os PDFs fornecem tanto texto extraído quanto imagens de páginas para modelos capazes de visão. Arquivos Word e PowerPoint fornecem texto extraído, enquanto planilhas seguem um processo separado que adiciona resumos e metadados. Para o Astra, o detalhe de PDF auto atualmente usa high. Documentação de entrada de arquivos da OpenAI
Se sua pergunta se refere à redação de uma política, pagar por imagens de página pode adicionar pouco valor. Converter essa política em Markdown revisado lhe dá uma maneira de enviar seu texto sem essas imagens.
Para um gráfico, desenho de engenharia ou fotografia, a informação visual pode ser essencial. Mantenha a imagem relevante na solicitação quando a tarefa depender dela.
Preços da API GPT-6 Astra
Conforme verificado em 20 de setembro de 2026, as taxas padrão da API de curto contexto do GPT-6 Astra são:
| Categoria de token | USD por milhão de tokens |
|---|---|
| Entrada | 10,00 dólares |
| Entrada em cache | 1,00 dólar |
| Gravações em cache | 12,50 dólares |
| Saída | 50,00 dólares |
Os cálculos abaixo usam a taxa de entrada de US$ 10 para tornar as representações do documento comparáveis. Eles excluem saída, ferramentas, gravações de cache e outros conteúdos de solicitações. Eles são equivalentes à taxa de entrada, em vez de previsões de uma fatura completa. Preços da API da OpenAI
A essa taxa, remover 100.000 tokens de entrada vale US$ 1 por leitura não cacheada. Reutilizar material de origem compacto em várias tarefas independentes pode tornar essa diferença significativa.
Nosso experimento local
Criamos um relatório de 40 páginas, um pacote de apenas imagens de 20 páginas, duas imagens de texto, um relatório do Word, uma apresentação do PowerPoint com 30 slides e uma planilha do Excel com 500 linhas. Todo o conteúdo era sintético. O pacote escaneado continha deliberadamente pouco texto; o relatório e a segunda imagem continham muito mais texto denso.
Executamos os arquivos através dos extratores SourceShelf do repositório, do renderizador semântico Markdown e do módulo de gravação Markdown em um Mac. As contagens incluem os metadados de origem e os cabeçalhos gerados. Os documentos foram convertidos, não resumidos.
O texto foi contado com tiktoken 0.14.0 usando o200k_base. Esse tokenizador não mapeia explicitamente o Astra, portanto essas são contagens locais aproximadas, não uma contagem oficial dos tokens de texto do Astra. Os tokens de imagem foram calculados usando as regras de patch documentadas do Astra. Para PDFs, assumimos imagens de página com 144 DPI e adicionamos texto nativo extraído localmente. A rasterização real de PDF e a extração de texto da OpenAI podem diferir. Nenhum arquivo foi enviado para a API, e nenhum uso da API foi cobrado durante este experimento.
PDFs e imagens de texto: a maior oportunidade
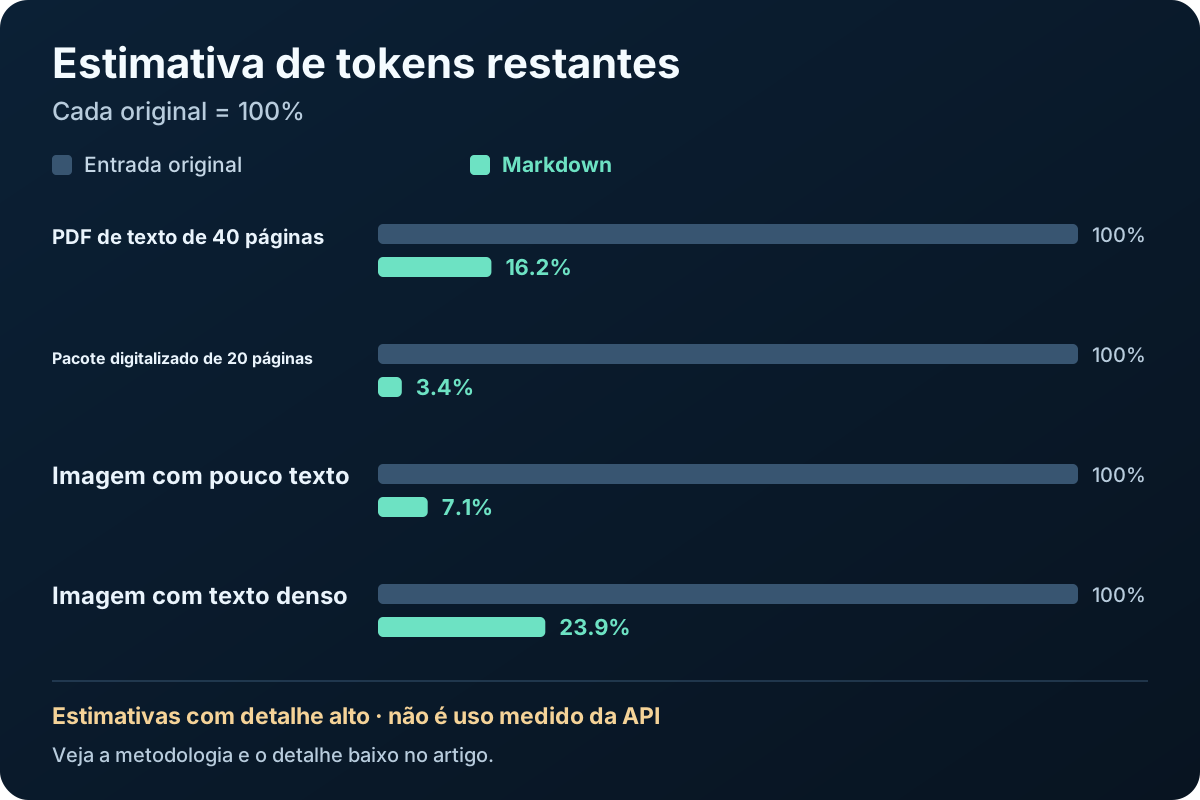
| Documento de teste | Tokens de entrada originais estimados | Tokens proxy Markdown | Redução estimada | Custo estimado de entrada (USD): original → Markdown |
|---|---|---|---|---|
| PDF de texto de 40 páginas | 112.449 | 18.184 | 83,8% | US$ 1,1245 → US$ 0,1818 |
| Pacote digitalizado de 20 páginas | 45.600 | 1.559 | 96,6% | US$ 0,4560 → US$ 0,0156 |
| Imagem de texto esparso, 1200 × 1600 | 2.280 | 162 | 92,9% | US$ 0,0228 → US$ 0,0016 |
| Imagem de texto densa, 1200 × 1600 | 2.280 | 545 | 76,1% | US$ 0,0228 → US$ 0,0055 |
Essas comparações usam os detalhes da imagem high. O gráfico normaliza cada original para 100%; os comprimentos das barras comparam representações dentro de um documento, não totais de tokens em todos os documentos. Por exemplo, uma imagem de 1200 × 1600 ocupa 38 × 50 patches de 32 pixels, ou 1.900 patches. O multiplicador 1,2 do Astra produz 2.280 tokens de imagem. Transformar a imagem esparsa em 162 tokens do Markdown revisado elimina a maior parte desse custo de entrada. Cálculos de tokens de imagem da OpenAI
Para o relatório de 40 páginas, a economia modelada é de aproximadamente US$ 0,94 por leitura não cacheada, ou US$ 94,27 em 100 leituras independentes à mesma taxa. Isso é uma extrapolação, não 100 solicitações de API medidas. Os acertos de cache reduziriam a diferença em dólares: a US$ 1 por milhão de tokens cacheados, a mesma diferença de token vale cerca de US$ 0,094 por leitura. As escritas no cache têm sua própria taxa.
As alterações nos detalhes da imagem alteram o resultado substancialmente. Usar low é outra opção quando ainda precisa enviar imagens. Aplicar o dimensionamento de imagem de baixo detalhe documentado às nossas imagens de página PDF assumidas reduziu as reduções estimadas do PDF para 37,0% para o relatório de texto e 66,3% para o pacote escaneado. A imagem independente densa caiu para 231 tokens de imagem em baixo detalhe — menos do que sua versão Markdown de 545 tokens. Não testamos se o modelo poderia ler essa imagem reduzida com precisão.
Arquivos do Office: a conversão sozinha não é a economia
Os arquivos do Office usados como controle contam uma história diferente:
| Documento de teste | Tokens do controle em texto simples | Tokens do Markdown do SourceShelf | Variação |
|---|---|---|---|
| Relatório do Word, 40 seções | 17.880 | 18.021 | +0,8% |
| Apresentação do PowerPoint, 30 slides | 5.370 | 5.674 | +5,7% |
| Planilha do Excel, 500 linhas de dados | 5.506 | 7.142 | +29,7% |
Esses controles contêm o texto original dos arquivos de teste; não são contagens de upload de API medidas. Eles mostram o custo dos cabeçalhos, proveniência, limites de slides e sintaxe da tabela Markdown. Comparar o tamanho de bytes do arquivo do Office comprimido com o Markdown não mediria as economias de tokens.
Para documentos do Office, a vantagem prática do SourceShelf é tornar o conteúdo legível, reutilizável e mais fácil de selecionar. Em um experimento de seleção manual separado, manter quatro seções relevantes do relatório Word convertido reduziu a carga de dados de 18.021 para 1.893 tokens: 89,5% menos. Manter três slides da apresentação convertida reduziu-a de 5.674 para 679 tokens: 88,0% menos.
Essas reduções excluem intencionalmente o material. Elas são apropriadas quando a questão só precisa dessas seções e não podem substituir uma revisão de todo o documento. As seleções foram feitas no Markdown exportado; não foram uma função automática de relevância.
Para cálculos de planilhas, mantenha o acesso ao arquivo de trabalho e a uma ferramenta de análise apropriada. As tabelas Markdown são um material de referência útil, mas não substituem a avaliação de fórmulas ou a análise completa de planilhas. Para coleções maiores, a recuperação é outra opção: a ferramenta File Search da OpenAI pode fornecer trechos relevantes em vez de colocar todos os documentos em cada solicitação.
Revise a conversão antes de confiar nela
Menos tokens são úteis apenas se as informações necessárias para a tarefa sobreviverem.
Nossas verificações recuperaram todas as palavras alfanuméricas esperadas, incluindo suas ocorrências repetidas, nos arquivos do Office, nas duas imagens independentes e no pacote digitalizado. O PDF de texto longo manteve 99,65% por essa verificação, com algumas omissões e texto reordenado. Uma verificação de retenção de palavras não prova que as relações de tabela, a ordem de leitura ou o significado permaneçam intactos.
Esses arquivos de teste sintéticos e limpos também não representam caligrafia difícil, gráficos complexos, escaneamentos ruins ou todos os documentos comerciais. O OCR e a conversão de formato do SourceShelf apresentam limitações. Revise nomes, valores, datas, tabelas e ordem de leitura; anexe a página ou a imagem original quando ela contiver evidências que o texto não consegue preservar.
Um fluxo de trabalho prático SourceShelf
- Converta localmente. Arraste seus PDFs,
.docx,.pptx,.xlsx, ou imagens compatíveis para o SourceShelf no Mac. A detecção e conversão de texto ocorrem no seu dispositivo. Conversão local de PDF - Inspecione o Markdown. Verifique as informações das quais sua próxima tarefa depende, especialmente o texto e as tabelas escaneados.
- Monte um Pacote focado. Inclua as fontes relevantes para a pergunta. Para tarefas mais restritas, prepare um trecho do Markdown exportado, preservando as etiquetas de fonte úteis. Pacotes de referência SourceShelf
- Envie texto e os elementos visuais necessários. Forneça o Markdown como texto para o seu fluxo de trabalho da API Astra. Inclua imagens individuais quando o conteúdo visual delas for importante. Um link de imagem Markdown sozinho não transmite seus pixels.
- Reuse a fonte revisada. Mantenha a conversão para tarefas futuras e atualize-a quando o original mudar. Verifique o uso real da API para validar as economias em seu próprio fluxo de trabalho.
A conversão local em si não envia o documento original para um servidor. Quando você envia Markdown ou imagens posteriormente para um modelo em nuvem, o conteúdo selecionado deixa seu dispositivo.
Tamanho do contexto, cache e limites de assinatura
Grandes contextos adicionam outro motivo para escolher com cuidado. As solicitações Astra com mais de 272.000 tokens de entrada apresentam taxas mais altas em toda a solicitação: o dobro das taxas de entrada e de cache, e 1,5 vezes a taxa de saída. Nossos casos de teste permaneceram abaixo desse limite; reduzir uma solicitação maior abaixo dele poderia gerar uma economia adicional. Conte a solicitação completa, incluindo histórico e ferramentas. Notas de preços do modelo Astra
Esses cálculos em dólares se referem ao uso da API. Eles não se traduzem diretamente em economias em uma assinatura ChatGPT de preço fixo ou em um número fixo de tarefas extras Codex.
Prepare uma vez, reutilize com cuidado
O hábito útil é simples: prepare a fonte uma vez, verifique-a e dê ao modelo o material que a tarefa precisa. Para trabalhos focados em texto com PDFs e escaneamentos, isso pode deixar substancialmente mais do seu orçamento de tokens disponível para o próprio trabalho.
Para outra maneira de manter o resultado portátil, veja nosso guia para Open Knowledge Format. Você pode manter fontes legíveis e seus metadados juntos à medida que suas ferramentas de IA mudam.
